Die größte Herausforderung ist selten die KI
Was erfolgreiche transdisziplinäre KI-Forschungsprojekte auszeichnet – ein Erfahrungsbericht aus dem Projektalltag von PowerAImage
von Luisa-Elene Pissors, wiss. Mitarbeiterin im Projekt PowerAImage
25.09.2026
Keywords: KI, Interdisziplinarität, Transdisziplinarität, Forschungskooperation, Forschungsdesign
Wenn von KI-Forschungsprojekten die Rede ist, denken viele zunächst an generative KI, leistungsfähige Sprachmodelle oder die Erzeugung neuer Inhalte. Dieser Beitrag richtet den Blick dagegen vor allem auf analytische KI – also auf Anwendungen, bei denen vorhandene Daten mithilfe von KI ausgewertet werden. Im Projekt PowerAImage, aus dessen Projektalltag im Folgenden berichtet wird, liegt zudem ein besonderer Schwerpunkt auf der Analyse von Bilddaten (insbesondere Bilder und Videos von Tieren).
Noch bevor das erste Modell trainiert werden kann, müssen grundlegende Fragen beantwortet werden – unabhängig davon, ob es um Bilder, Texte, Zahlen oder Töne geht: Was genau soll erkannt oder ausgewertet werden? Welche Daten werden dafür benötigt? Und woran lässt sich feststellen, ob die KI ihre Aufgabe richtig gelöst hat? Seit dem Start des Projekts PowerAImage Anfang 2026 begleiten wir mehrere transdisziplinäre KI-Projekte aus unterschiedlichsten Anwendungsbereichen. Schnell hat sich dabei gezeigt: Erfolgreiche KI-Projekte scheitern selten an der Wahl des Modells. Viel entscheidender sind klare Fragestellungen, geeignete Daten und eine enge Zusammenarbeit zwischen Fachdomäne und KI-Entwicklung (vgl. Dahm & Stolley 2026, S. 52; Allianz für KI-Kompetenz 2025, S. 4–6).
Im Folgenden stellen wir einige der häufigsten Herausforderungen vor, denen wir in transdisziplinären KI-Projekten begegnen, und machen Vorschläge, wie sich diese mit einer guten Planung, geeigneten Daten und einer engen Zusammenarbeit vermeiden lassen.
Ein erfolgreiches KI-Projekt beginnt mit einer klar formulierten Fragestellung
Oft beginnt ein KI-Projekt mit einer scheinbar eindeutigen Anforderung wie „Das System soll die abgebildeten Tiere zählen.“ Doch Aufgabenstellungen wie diese werden auf den zweiten Blick grundlegende Fragen auf: Sollen nur vollständig sichtbare Tiere gezählt werden oder auch teilweise verdeckte? Werden Jungtiere berücksichtigt? Zählen Tiere am Bildrand oder außerhalb eines definierten Bereichs ebenfalls? Gerade in transdisziplinären Projekten treffen unterschiedliche Perspektiven aufeinander. Was für Domänenexpert:innen selbstverständlich erscheint, ist für KI-Entwickler:innen meist nicht eindeutig definiert – und umgekehrt. Erst ein gemeinsames Verständnis der Aufgabenstellung und der Erfolgskriterien schafft die Grundlage für eine zielgerichtete Entwicklung (vgl. Dahm & Stolley 2026, S. 39–40; Allianz für KI-Kompetenz 2025, S. 6).
Eine präzise formulierte Fragestellung ist die Basis für alle weiteren Projektschritte – von der Datenerhebung über die Annotation bis hin zur Entwicklung und Bewertung des Modells. Viele Herausforderungen, die erst während des Trainings oder der Evaluation sichtbar werden, lassen sich auf eine unklare Definition der ursprünglichen Aufgabenstellung zurückführen (vgl. Kutzias et al. 2023, S. 9; Dahm & Stolley 2026, S. 23–25).
Hilfreiche Fragen zum Projektstart finden Sie am Ende des Blogbeitrags.
Ein Modell lernt nur die Welt kennen, die wir ihm zeigen
Bei vielen KI-Projekten steht am Anfang die Aussage: „Wir haben tausende Daten.“ Auch wenn eine breite Datengrundlage fast immer von Vorteil ist, so lautet die zentrale Frage jedoch meist nicht, wie viele Daten vorhanden sind, sondern ob diese die Vielfalt der späteren Anwendung tatsächlich repräsentieren (vgl. Kutzias et al. 2023, S. 18; Allianz für KI-Kompetenz 2025, S. 4).
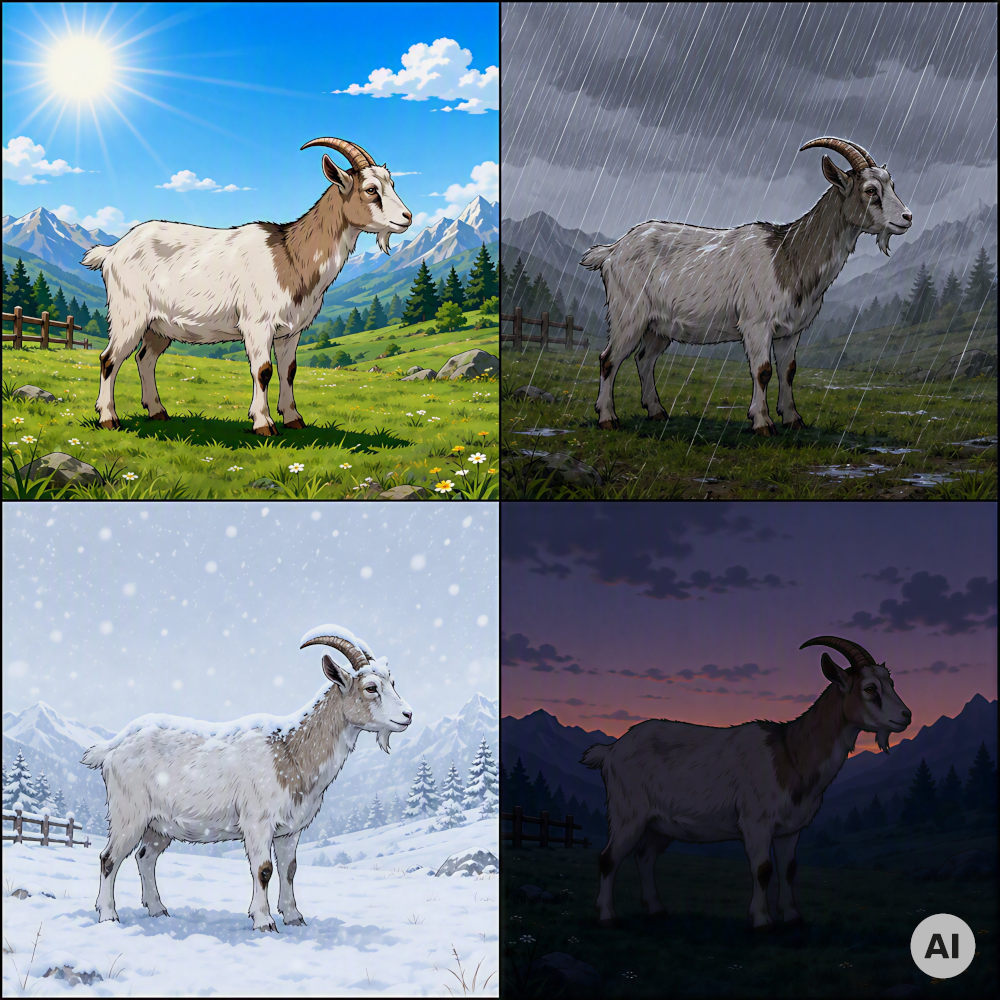
Selbst wenn die benötigten Informationen im Datensatz enthalten sind, bedeutet das noch nicht, dass ein KI-Modell unter realen Bedingungen zuverlässig funktioniert. Ein Modell lernt ausschließlich aus den Beispielen, die ihm während des Trainings gezeigt werden. Sind diese Beispiele nicht repräsentativ für den späteren Einsatz, stößt das Modell schnell an seine Grenzen (vgl. Kutzias et al. 2023, S. 24; Dahm & Stolley 2026, S. 13, 32–34). Bereits bei der Datenerhebung werden daher wichtige Weichen gestellt. Wo werden die Daten erfasst? Aus welcher Perspektive werden Bilder aufgenommen? Zu welchen Tages- und Jahreszeiten erfolgen die Aufnahmen? Welche Wetterbedingungen oder Umgebungen werden berücksichtigt? All diese Entscheidungen bestimmen, welchen Ausschnitt der Realität ein Modell später kennenlernt (vgl. Kutzias et al. 2023, S. 18, 24).
Werden Bilddaten beispielsweise ausschließlich an sonnigen Sommertagen oder immer am selben Standort erfasst, lernt das Modell genau diese Bedingungen kennen. Ähnliches gilt für Datensätze, die nur aus einer Kameraperspektive, für eine bestimmte Objektgruppe oder in einem einzelnen räumlichen Setting erhoben wurden. Treten später Regen, Nebel, Schnee oder schlechte Lichtverhältnisse auf bzw. werden neue Umgebungen hinzugefügt, kann die Erkennungsleistung deutlich abnehmen. Im ungünstigsten Fall lernt das Modell dabei eher die Aufnahmebedingungen oder die Umgebung als die eigentliche Aufgabe kennen (vgl. Kutzias et al. 2023, S. 24).
Ein repräsentativer Datensatz sollte daher möglichst viele Situationen abbilden, die später auch im praktischen Einsatz auftreten können. Je vielfältiger und realistischer die Trainingsdaten sind, desto robuster kann ein KI-Modell auf neue, unbekannte Situationen reagieren. Dabei ist die Vielfalt der Daten wichtiger als ihre reine Menge. Ein kleiner, aber vielfältiger Datensatz ist für viele Anwendungen besser geeignet als ein sehr großer Datensatz, der nur einen kleinen Ausschnitt der späteren Realität abbildet (vgl. Kutzias et al. 2023, S. 18, 24; Dahm & Stolley 2026, S. 30–34; Allianz für KI-Kompetenz 2025, S. 4).
Menschen sehen dieselben Daten unterschiedlich
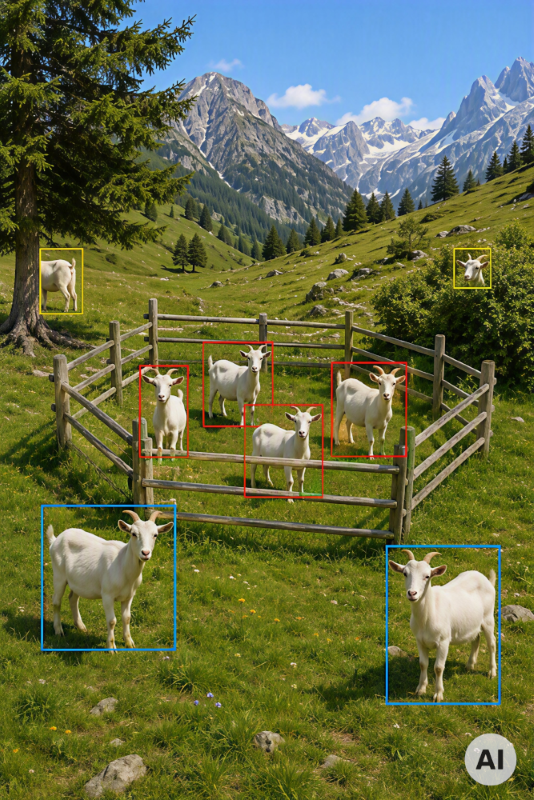
Nachdem die Daten erhoben wurden, müssen sie für das Training eines KI-Modells aufbereitet werden. Bei Computer-Vision-Projekten geschieht dies durch Annotation (auch Labeling genannt). Dabei werden Objekte in Bildern oder Videos markiert und mit den gewünschten Klassen oder Informationen versehen. Auf den ersten Blick scheint diese Aufgabe eindeutig. Die Praxis zeigt jedoch, dass verschiedene Personen dieselben Daten unterschiedlich interpretieren (vgl. Beck 2023, S. 334–335). Wenn beispielsweise alle Tiere auf einem Bild markiert werden sollen, zählt dann ein teilweise verdecktes Exemplar noch dazu? Wo endet das Objekt und wo beginnt der Hintergrund? Person A markiert ein teilweise sichtbares Tier, während sich Person B dagegen entscheidet. Beide Entscheidungen sind nachvollziehbar, für ein KI-Modell stellen sie jedoch unterschiedliche Trainingsinformationen dar.
Ohne klare Annotation Guidelines entstehen inkonsistente Labels. Dadurch lernt das Modell nicht nur das eigentliche Objekt, sondern auch die unterschiedlichen Entscheidungen der Personen, die die Annotationen vornehmen. Einheitliche Richtlinien helfen dabei, Grenzfälle eindeutig zu definieren und eine konsistente Datengrundlage für das spätere Modelltraining zu schaffen. Regelmäßige Qualitätskontrollen stellen zudem sicher, dass Fehler oder Inkonsistenzen frühzeitig erkannt und behoben werden (vgl. Beck 2023, S. 341–342).
Hilfreiche Hinweise zur Erstellung einer Annotation Guideline für Computer-Vision-Projekte finden Sie am Ende des Beitrags.
Die vermeintliche Wahrheit ist oft nur die beste verfügbare Einschätzung
Bei der Entwicklung und Bewertung von KI-Modellen wird von der sogenannten „Ground Truth“ gesprochen. Damit sind die Referenzdaten oder Labels gemeint, anhand derer ein Modell trainiert und bewertet wird. Der Begriff vermittelt den Eindruck, dass es sich dabei um eine objektive und eindeutig feststehende Wahrheit handelt. Bei Fragestellungen, die menschliche Einschätzungen erfordern, ist diese Referenz jedoch nicht immer eindeutig. Sie bildet dann vielmehr die nach festgelegten Kriterien getroffene Bewertung einer oder mehrerer Personen ab (vgl. Warfield et al. 2004, S. 903–904).
Dies wird besonders bei Fragestellungen deutlich, für die es keine eindeutig richtige Antwort gibt. Ist ein Tier auf einem Bild noch ausreichend sichtbar, um gezählt zu werden? Welches Verhalten zeigt ein Tier in einer bestimmten Situation? Welche Lautäußerung gehört zu welchem Ereignis? Oder ab wann gilt ein Krankheitsbild als auffällig? Selbst erfahrene Fachpersonen kommen bei solchen Fragestellungen nicht immer zu derselben Bewertung (vgl. Beck 2023, S. 334, 348-349; Warfield et al. 2004, S. 903–904). In der KI-Forschung wird die Übereinstimmung zwischen verschiedenen annotierenden Personen mithilfe des Inter-Annotator Agreement untersucht. Eine geringe Übereinstimmung bedeutet dabei nicht zwangsläufig schlechte Annotationen – sie kann auch darauf hinweisen, dass die zugrunde liegende Fragestellung Interpretationsspielraum lässt.
Für das Modell sind Unsicherheiten in den bereitgestellten Labels jedoch nicht automatisch nachvollziehbar. Es erhält ausschließlich die bereitgestellten Labels als Trainingsgrundlage und übernimmt die darin enthaltenen Entscheidungen. Was für Menschen unterschiedliche, aber nachvollziehbare Einschätzungen sind, stellt für ein KI-Modell unterschiedliche Wahrheiten dar. Gerade in transdisziplinären KI-Projekten ist es deshalb wichtiger, nachvollziehbare und konsistente Bewertungsmaßstäbe festzulegen, als eine vermeintlich objektive Wahrheit erzwingen zu wollen (vgl. Beck 2023, S. 334, 342, 349; Warfield et al. 2004, S. 903–904).
Gute Testergebnisse bedeuten nicht automatisch ein gutes Modell
Die Leistungsfähigkeit eines KI-Modells wird üblicherweise anhand von Testdaten bewertet. Eine hohe Genauigkeit bedeutet jedoch nicht zwangsläufig, dass das Modell im Praxiseinsatz zuverlässig funktioniert. Für eine aussagekräftige Evaluation müssen Trainings-, Validierungs- und Testdaten tatsächlich voneinander unabhängig sein (vgl. Kaufman et al. 2011, S. 556–563; Barz & Denzler 2020, S. 1–4).
Wird beispielsweise aus einem zehnminütigen Video eine große Anzahl von Einzelbildern extrahiert und anschließend zufällig auf Trainings- und Testdaten verteilt, können nahezu identische Bilder in beiden Datensätzen landen. Das Modell sieht im Test somit keine neuen Situationen, sondern bereits bekannte Szenen wieder. Die gemessene Genauigkeit fällt entsprechend hoch aus, obwohl die tatsächliche Leistung im praktischen Einsatz deutlich geringer sein kann (vgl. Barz & Denzler 2020, S. 1–4; Kaufman et al. 2011, S. 556–563). Dieses Phänomen wird als „Train-Test-Leakage“ bezeichnet und stellt eine Form von Data Leakage dar, bei der Trainings- und Testdaten nicht ausreichend unabhängig voneinander sind. Dadurch können Evaluationsergebnisse unrealistisch gut ausfallen. Trainings-, Validierungs- und Testdaten sollten deshalb so aufgeteilt werden, dass zusammengehörige oder stark ähnliche Aufnahmen nicht in unterschiedlichen Datensplits landen. Gleichzeitig sollten die Testdaten die späteren Einsatzbedingungen möglichst realistisch widerspiegeln.
Kennzahlen müssen im Kontext interpretiert werden
Eine Modellgenauigkeit von 95 % klingt zunächst beeindruckend. Ohne den richtigen Kontext sagt diese Zahl jedoch nur wenig über die tatsächliche Leistungsfähigkeit eines KI-Modells aus. Ein einfaches Beispiel zeigt, warum: Enthalten 95 % aller Bilder kein relevantes Objekt und das Modell sagt in allen Fällen „kein Objekt vorhanden“ voraus, erreicht es eine Genauigkeit von 95 %, obwohl es das eigentliche Problem überhaupt nicht löst (vgl. He & Garcia 2009, S. 1276).
Kennzahlen sollten daher immer im Zusammenhang mit der zugrunde liegenden Fragestellung interpretiert werden. Entscheidend ist nicht nur, wie gut ein Modell ist, sondern auch, welche Fehler es macht, unter welchen Bedingungen diese auftreten und welche Auswirkungen sie in der Praxis haben (vgl. He & Garcia 2009, S. 1275–1278).
Datenqualität ist wichtiger als Modellkomplexität
Die bisherigen Beispiele zeigen, dass der Erfolg eines KI-Projekts bereits vor der Modellauswahl entschieden wird. In Diskussionen über KI stehen neue Modellarchitekturen, größere neuronale Netze oder leistungsfähigere Hardware im Mittelpunkt. Unsere Erfahrungen aus PowerAImage zeigen jedoch ein anderes Bild: Die Qualität eines KI-Systems wird häufig stärker durch die Qualität der Daten als durch die Wahl des Modells beeinflusst (vgl. Dahm & Stolley 2026, S. 30–34; Allianz für KI-Kompetenz 2025, S. 4–6).
Unvollständige Datensätze, unausgewogene Klassenverteilungen oder fehlerhafte Annotationen lassen sich auch durch moderne KI-Modelle nicht vollständig kompensieren. Die Leistungsfähigkeit eines KI-Modells kann daher niemals besser sein als die Qualität der zugrunde liegenden Daten und Labels. Selbst leistungsfähigste Verfahren können nur auf Grundlage der Informationen lernen, die ihnen während des Trainings zur Verfügung stehen. Auch die modernste Modellarchitektur kann fehlende oder fehlerhafte Informationen in den Daten nicht ersetzen. Es lohnt sich daher, Zeit in die Verbesserung der Datenbasis zu investieren, statt ausschließlich viele Stunden in die Modelloptimierung zu stecken (vgl. Kutzias et al. 2023, S. 21; Dahm & Stolley 2026, S. 32–34; Allianz für KI-Kompetenz 2025, S. 4–6; Beck 2023, S. 331–332, 341–342; He & Garcia 2009, S. 1263–1266).
Dokumentation ist kein Selbstzweck
„Mit welchem Datensatz wurde dieses Modell eigentlich trainiert?“
Diese Frage taucht in vielen KI-Projekten früher oder später auf. Oft lässt sie sich dann jedoch nicht mehr eindeutig beantworten. Während eines Projekts werden zahlreiche Entscheidungen getroffen. Welche Daten wurden erhoben? Welche wurden ausgeschlossen? Welche Version des Datensatzes wurde für das Training verwendet? Mit welchen Parametern wurde das Modell trainiert? Solange das Projekt läuft, erscheinen diese Informationen selbstverständlich. Einige Monate später sind sie jedoch oft nicht mehr nachvollziehbar. Eine sorgfältige Dokumentation ist daher weit mehr als eine organisatorische Pflicht. Sie bildet das Fundament, um Ergebnisse nachvollziehen, Modelle reproduzieren und getroffene Entscheidungen verstehen zu können. Dies betrifft sowohl die Datenerhebung und -annotation als auch den gesamten Trainings- und Evaluationsprozess (vgl. Kutzias et al. 2023, S. 17, 24; Dahm & Stolley 2026, S. 71–73).
Dokumentiert werden sollten unter anderem Datensatzversionen, verwendete Kameras oder Aufnahmegeräte, Annotationsrichtlinien, Trainings- und Testaufteilungen, Modell- und Softwareversionen sowie die verwendeten Hyperparameter. Ohne diese Informationen ist es schwierig, Ergebnisse zu reproduzieren oder Verbesserungen systematisch nachzuvollziehen (vgl. Kutzias et al. 2023, S. 17, 24; Dahm & Stolley 2026, S. 71–73). Eine gute Dokumentation ist nicht nur für andere Projektbeteiligte hilfreich. Meistens ist sie auch die einzige Möglichkeit, Entscheidungen und Ergebnisse Monate oder sogar Jahre später noch beurteilen zu können. Ebenso wichtig ist es, die während eines Projekts gewonnenen Erkenntnisse festzuhalten. Welche Annahmen haben sich bestätigt? Welche Herausforderungen sind aufgetreten? Welche Empfehlungen ergeben sich für zukünftige Projekte? Gerade vermeintliche Fehlschläge liefern wertvolle Erkenntnisse und helfen dabei, ähnliche Fehler zukünftig zu vermeiden (vgl. Dahm & Stolley 2026, S. 58–60).
Viele der beschriebenen Herausforderungen werden erst während eines Projekts sichtbar. Erfolgreiche KI-Projekte zeichnen sich deshalb weniger dadurch aus, dass bereits zu Projektbeginn alle Entscheidungen endgültig feststehen, sondern dadurch, dass neue Erkenntnisse kontinuierlich in die Fragestellung, den Datensatz, die Annotation Guideline und das Modell zurückfließen. KI-Projekte sind keine linearen Prozesse, sondern iterative Lernprozesse, in denen sich sowohl das Verständnis der Aufgabe als auch die Datengrundlage und die Lösung schrittweise weiterentwickeln (vgl. Kutzias et al. 2023, S. 6, 18, 24; Dahm & Stolley 2026, S. 58–64; Allianz für KI-Kompetenz 2025, S. 6).
Kommunikation ist ein technischer Erfolgsfaktor
Erfolgreiche inter- und transdisziplinäre KI-Projekte entstehen, wenn Fachdomäne und KI-Entwicklung von Anfang an zusammenarbeiten. Domänenexpert:innen bringen das bereichsspezifisches Wissen ein, KI-Entwickler:innen die technische Expertise. Erst die Kombination beider Perspektiven ermöglicht eine Lösung, die fachlich sinnvoll und technisch belastbar ist (vgl. Dahm & Stolley 2026, S. 39–40; Allianz für KI-Kompetenz 2025, S. 6). Die Qualität der Fragestellung, der Daten, der Annotationen und der Evaluation lässt sich dabei unmittelbar durch zwei simple Prinzipien verbessern: Kommunikation und Transparenz. So lassen sich viele Herausforderungen vermeiden, bevor die erste Zeile Code geschrieben wird (vgl. Kutzias et al. 2023, S. 18; Dahm & Stolley 2026, S. 48–52).
Die beschriebenen Herausforderungen betreffen unterschiedliche Phasen eines KI-Projekts. Ihnen allen ist jedoch gemeinsam, dass sie meist lange vor dem eigentlichen Modelltraining entstehen, beispielsweise bei der Definition der Fragestellung, der Datenerhebung, der Annotation oder der Zusammenarbeit unterschiedlicher Fachdisziplinen. Unsere Erfahrungen aus PowerAImage zeigen: Große Leistungsgewinne entstehen nicht nur durch leistungsstärkere Modelle oder Hardware, sondern ebenso durch Verbesserungen der Datengrundlage. Dafür sind klare Fragestellungen, geeignete Daten, nachvollziehbare Prozesse und ein kontinuierlicher Austausch zwischen Fachdomäne und KI-Entwicklung entscheidend (vgl. Dahm & Stolley 2026, S. 30–34, 39–40, 48–51; Allianz für KI-Kompetenz 2025, S. 4–6). Die größte Herausforderung eines KI-Projekts ist daher nicht zwingend die KI selbst. Bevor eine KI lernen kann, müssen sich zunächst Menschen darauf einigen, was überhaupt gelernt werden soll. Genau darin sehen wir einer der zentralen Aufgaben von PowerAImage: Fachwissen, Daten und KI-Kompetenz zusammenzubringen, um gemeinsam belastbare und praxisnahe KI-Lösungen zu entwickeln.
Quellen
Allianz für KI-Kompetenz in Deutschland (2025): Lessons Learned Whitepaper. Whitepaper. Herausgegeben von Microsoft Deutschland GmbH, München. Online unter URL: https://msftstories.thesourcemediaassets.com/sites/40/2025/06/Microsoft_Lessons-Learned-Whitepaper.pdf.
Barz, B. & Denzler, J. (2020): Do We Train on Test Data? Purging CIFAR of Near-Duplicates. In: Journal of Imaging, 6(6), 41. DOI: 10.3390/jimaging6060041.
Beck, J. (2023): Quality aspects of annotated data: A research synthesis. In: AStA Wirtschafts- und Sozialstatistisches Archiv, 17, 331–353. DOI: 10.1007/s11943-023-00332-y.
Dahm, M. H. & Stolley, J. (2026): Umsetzung von KI-Projekten in KMU. Erfolgsfaktoren, Herausforderungen und Handlungsempfehlungen. Wiesbaden: Springer Gabler. DOI: 10.1007/978-3-658-51022-0.
He, H. & Garcia, E. A. (2009): Learning from Imbalanced Data. In: IEEE Transactions on Knowledge and Data Engineering, 21(9), 1263–1284. DOI: 10.1109/TKDE.2008.239.
Kaufman, S., Rosset, S. & Perlich, C. (2011): Leakage in Data Mining: Formulation, Detection, and Avoidance. In: Proceedings of the 17th ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, 556–563. DOI: 10.1145/2020408.2020496.
Kutzias, D., Dukino, C. & Leuteritz, J.-P. (2023): Leitfaden zur Durchführung von KI-Projekten. Menschenzentrierung von der Idee bis zur Anwendung. Stuttgart: Fraunhofer-Institut für Arbeitswirtschaft und Organisation IAO. DOI: 10.24406/publica-1637.
Warfield, S. K., Zou, K. H. & Wells, W. M. (2004): Simultaneous Truth and Performance Level Estimation (STAPLE): An Algorithm for the Validation of Image Segmentation. In: IEEE Transactions on Medical Imaging, 23(7), 903–921. DOI: 10.1109/TMI.2004.828354.